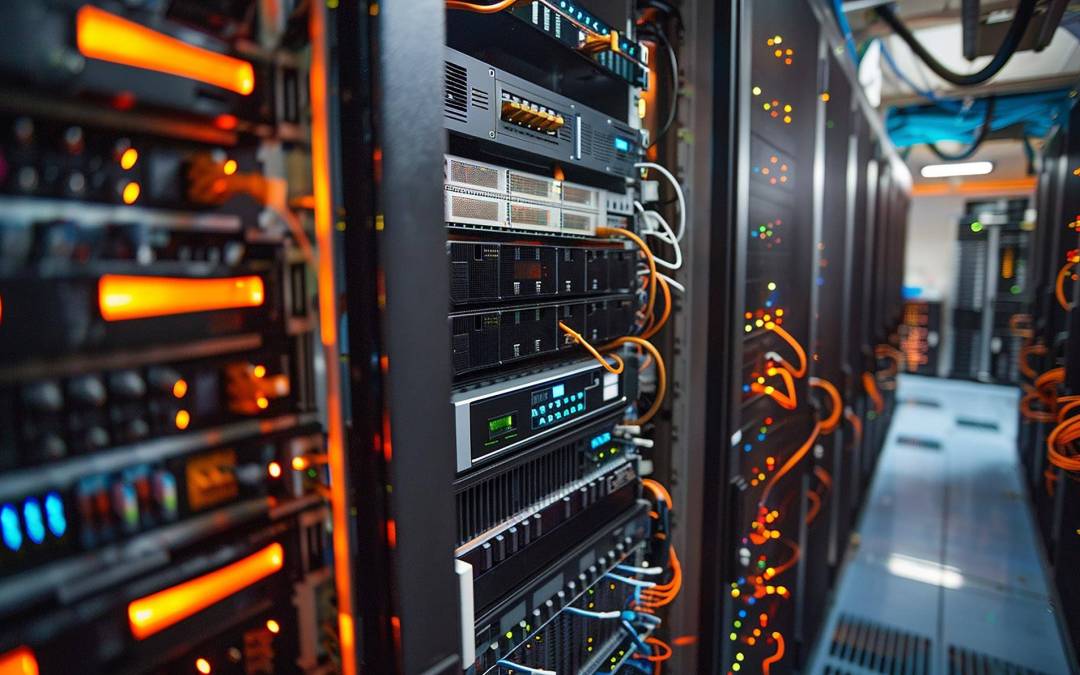
Serwery to wyspecjalizowane systemy, które udostępniają zasoby, dane i usługi innym urządzeniom w sieci, a więc bezpośrednio odpowiadają na pytanie z tytułu, czym są i do czego mogą służyć. Mogą działać jako urządzenia fizyczne, maszyny wirtualne, kontenery albo usługi chmurowe, obsługują strony i aplikacje, bazy danych, pocztę, pliki, kopie zapasowe, gry oraz funkcje bezpieczeństwa. Współczesne środowiska łączą je w architektury warstwowe i rozproszone, w centrach danych oraz na brzegu sieci, także z przyspieszeniem obliczeń przez GPU w zastosowaniach AI.
Czym jest serwer?
Serwer to komputer lub system komputerowy, który udostępnia zasoby, dane albo usługi innym urządzeniom zwanym klientami poprzez sieć. Działa w modelu klient–serwer, gdzie klient wysyła żądanie, a serwer je przetwarza i odsyła odpowiedź. Serwerem może być sprzęt fizyczny, maszyna wirtualna, kontener albo instancja w chmurze, co pozwala dopasować koszt i wydajność do potrzeb. W zastosowaniach sztucznej inteligencji znaczenie zyskują serwery z GPU lub wyspecjalizowanymi akceleratorami, które zapewniają wysoką przepustowość pamięci i łącza między akceleratorami, wymagają też skutecznego chłodzenia.
Serwery funkcjonują zwykle w centrach danych, gdzie zapewnia się zasilanie awaryjne, systemy chłodzenia, ochronę przeciwpożarową i zabezpieczenia fizyczne. W praktyce wykorzystuje się konfiguracje dedykowane dla jednego odbiorcy albo współdzielone pomiędzy wielu użytkowników, a w chmurze zasoby dostarczane są na żądanie w modelu opłat za wykorzystanie.
Jakie są rodzaje serwerów i do czego mogą służyć?
Podstawowe typy obejmują serwer internetowy, aplikacyjny, bazodanowy, plikowy, pocztowy, DNS, proxy i DHCP. Serwer internetowy dostarcza strony i pliki poprzez HTTP i HTTPS. Serwer aplikacji realizuje logikę biznesową, taką jak uwierzytelnianie oraz przetwarzanie operacji. Serwer baz danych przechowuje oraz udostępnia uporządkowane informacje. Serwer plików umożliwia centralne składowanie i kontrolę dostępu do dokumentów. Serwer pocztowy obsługuje wymianę wiadomości e-mail. Serwer DNS tłumaczy nazwy domen na adresy IP. Serwer proxy pośredniczy w ruchu, filtruje treści, zwiększa bezpieczeństwo i buforuje dane. Serwer DHCP automatycznie przydziela adresy IP w sieci.
W praktyce usługi internetowe łączą kilka ról jednocześnie. Typowa architektura wykorzystuje serwer DNS, serwer WWW, serwer aplikacji i bazę danych, a także pamięć podręczną, system kopii zapasowych oraz moduł równoważenia obciążenia, aby zapewnić szybkość działania, spójność danych i odporność na awarie.
Jak klasyfikuje się serwery?
Najważniejsze kryteria klasyfikacji obejmują przeznaczenie, formę sprzętową, sposób udostępniania zasobów, obciążenie i lokalizację. Ze względu na przeznaczenie wyróżnia się serwery webowe, bazodanowe, plikowe, pocztowe i aplikacyjne. Według formy sprzętowej spotyka się jednostki wieżowe, montowane w szafach rackowych oraz kasetowe. W centrach danych popularność zyskują konstrukcje rackowe, ponieważ pozwalają na dużą gęstość upakowania, łatwą rozbudowę i sprawne zarządzanie przestrzenią.
Według sposobu udostępniania zasobów można mówić o serwerach fizycznych, wirtualnych i chmurowych. Pod względem obciążenia występują konfiguracje ogólnego przeznaczenia, wysokowydajne, a także przyspieszane GPU dla zadań AI. Lokalizacja dzieli serwery na lokalne, w centrach danych oraz funkcjonujące na brzegu sieci, gdzie część przetwarzania przenosi się bliżej użytkownika w celu obniżenia opóźnień.
Jak działają serwery krok po kroku?
Pełny przebieg obsługi żądania można opisać następująco:
- Klient lub aplikacja wysyła żądanie przez sieć.
- System DNS odnajduje adres IP docelowej usługi.
- Żądanie trafia do serwera, zapory lub modułu równoważenia obciążenia.
- Następuje uwierzytelnienie i sprawdzenie uprawnień użytkownika.
- Aplikacja przetwarza żądanie, korzystając w razie potrzeby z bazy danych, pamięci podręcznej i zewnętrznych API.
- Serwer odsyła odpowiedź do klienta.
- System monitoringu rejestruje czas odpowiedzi, błędy, obciążenie i dostępność.
Jakie są kluczowe komponenty serwera?
Na poziomie sprzętowym krytyczne są procesor CPU, pamięć RAM, dyski HDD, SSD lub NVMe, karta sieciowa, płyta główna, kontroler RAID, redundantne zasilacze oraz system chłodzenia. Warstwa systemowa obejmuje system operacyjny i oprogramowanie serwerowe, które udostępnia konkretną usługę.
Wydajność kształtuje liczba i szybkość rdzeni CPU, ilość RAM, przepustowość i opóźnienia pamięci masowej, a także szybkość interfejsów sieciowych i możliwość wykonywania zadań równolegle. W zastosowaniach AI stosuje się GPU i akceleratory, które wymagają wysokiej przepustowości pamięci oraz szybkich połączeń między układami, co podnosi wymagania wobec zasilania i chłodzenia.
Od czego zależy wydajność i dostępność?
Całościowa wydajność usługi bywa ograniczona przez najsłabszy element, którym może być CPU, pamięć, dysk, sieć albo baza danych. Dostępność zwiększa się przez redundancję kluczowych komponentów, w tym zasilaczy, dysków, połączeń sieciowych i samych serwerów. Wraz ze wzrostem mocy obliczeniowej oraz gęstości upakowania rośnie zużycie energii i zapotrzebowanie na chłodzenie, co wpływa na parametry centrum danych i jego koszty eksploatacji.
Centra danych dostarczają zasilanie podstawowe i awaryjne, kontrolę klimatu oraz zabezpieczenia fizyczne, co minimalizuje ryzyko przerw w działaniu usług, a w konsekwencji ogranicza przestoje krytycznych systemów.
Jak skalować i równoważyć obciążenie?
Skalowanie pionowe polega na zwiększaniu zasobów pojedynczego serwera, a poziome na dodawaniu kolejnych serwerów do klastra. Równoważenie obciążenia rozdziela żądania między wiele instancji, poprawia czas odpowiedzi i zwiększa odporność na awarie. Spójności i ciągłości usług sprzyjają kopie zapasowe, replikacja danych oraz plany odtwarzania awaryjnego. Bezpieczeństwo obejmuje regularne aktualizacje, kontrolę dostępu, szyfrowanie, zapory sieciowe, monitoring i rejestrowanie zdarzeń, co umożliwia wczesne wykrywanie incydentów oraz analizę przyczyn.
Czym są wirtualizacja i konteneryzacja?
Wirtualizacja pozwala uruchamiać wiele niezależnych maszyn na jednym serwerze fizycznym, co poprawia wykorzystanie zasobów i elastyczność. Konteneryzacja izoluje aplikacje z ich zależnościami, ułatwia spójne wdrażanie i przenoszenie między środowiskami. W praktyce wirtualizacja wprowadza dodatkową warstwę zarządzania i niewielki narzut, a chmura zapewnia szybkie uruchamianie zasobów z zachowaniem kontroli kosztów i konfiguracji.
Jakie są zależności między warstwami?
Architektura serwerowa składa się z warstwy sprzętowej do obliczeń, pamięci masowej, sieci i zasilania, warstwy wirtualizacji, systemu operacyjnego, oprogramowania serwerowego, warstwy sieciowej z routerami, przełącznikami, zaporami, DNS i równoważeniem obciążenia, warstwy danych z bazami, magazynami obiektowymi, systemami plików i kopiami zapasowymi oraz warstwy zarządzania obejmującej monitoring, automatyzację, aktualizacje i reagowanie na incydenty.
Usługi internetowe zwykle korzystają jednocześnie z DNS, serwera WWW, serwera aplikacji i bazy danych, a ich efektywność zależy od właściwego zestrojenia wszystkich warstw. W środowiskach brzegowych część logiki przenosi się bliżej źródła danych w celu obniżenia opóźnień i oszczędności transferu.
Ile energii zużywają centra danych i serwery?
W 2024 roku centra danych zużyły około 415 TWh energii elektrycznej, co stanowiło około 1,5% globalnej konsumpcji energii elektrycznej. Same serwery odpowiadają średnio za około 60% zapotrzebowania energetycznego nowoczesnych obiektów, przy czym udział ten zależy od charakteru centrum danych. Przeciętne centrum danych wymaga mocy rzędu 5–10 MW, a duże obiekty hiperskalowe sięgają 100 MW lub więcej.
Szczególne znaczenie mają przyspieszane serwery AI. W 2024 roku stanowiły mniej niż 5% parków serwerowych, ale odpowiadały za około 20% zużycia energii centrów danych. Prognozy wskazują szybki wzrost ich zapotrzebowania na energię około 30% rocznie w scenariuszu bazowym, wobec około 9% dla serwerów tradycyjnych. Te dynamiki wymuszają inwestycje w zasilanie, chłodzenie i optymalizację obciążeń, a także promują wdrożenia bardziej efektywnych architektur.
Dlaczego serwery AI i edge computing zyskują na znaczeniu?
Ekosystem AI rośnie dzięki dostępności wyspecjalizowanych akceleratorów oraz zapotrzebowaniu na trening i inferencję modeli. W segmencie generatywnej AI serwery oparte na GPU odpowiadały w 2025 roku za 73,9% udziału przychodów według szacunków rynkowych, co potwierdza dominację rozwiązań GPU w tej klasie obciążeń. Równolegle analizy przewidywały blisko 7% wzrost dostaw serwerów w 2025 roku napędzany rozwojem chmury i popytem na infrastrukturę AI. Serwery AI wymagają szybkich połączeń między akceleratorami, dużej przepustowości pamięci oraz intensywnego chłodzenia, dlatego ich projektowanie i eksploatacja istotnie różnią się od systemów ogólnego przeznaczenia.
Edge computing przenosi część przetwarzania bliżej użytkownika lub urządzenia, co obniża opóźnienia i ogranicza ruch do centrów danych. Zastosowania brzegowe obejmują m.in. monitoring przemysłowy, autonomiczne pojazdy, robotykę, inteligentne miasta oraz urządzenia IoT, gdzie liczy się szybkość reakcji i lokalne przetwarzanie danych. Zyski z niższych opóźnień i mniejszego transferu równoważą wyzwania związane z zarządzaniem rozproszoną infrastrukturą.
Gdzie działają serwery i jakie mają wymagania środowiskowe?
Serwery pracują w serwerowniach i centrach danych wyposażonych w zasilanie awaryjne, systemy chłodzenia, ochronę przeciwpożarową oraz zabezpieczenia fizyczne. W środowiskach tych dominują rozwiązania rackowe ułatwiające skalowanie i serwis, a także zwiększające gęstość upakowania urządzeń w ograniczonej przestrzeni. Na brzegu sieci instaluje się węzły blisko użytkowników lub urządzeń, co umożliwia lokalne przetwarzanie i krótsze czasy odpowiedzi, lecz wymaga procedur utrzymania w wielu lokalizacjach.
Wysokowydajne konfiguracje, w tym systemy AI z GPU, generują znaczną ilość ciepła, więc ich niezawodność zależy od efektywnego chłodzenia oraz stabilnego zasilania. Wraz ze skalą rosną obciążenia energetyczne, co potwierdzają charakterystyczne wartości mocy dla obiektów oraz udział serwerów w zapotrzebowaniu na energię całych centrów danych.
Co dalej z rynkiem serwerów?
W najbliższym czasie utrzyma się popyt na infrastrukturę chmurową i platformy do AI. Prognozy zakładają wzrost dostaw serwerów wraz z rosnącą rolą serwerów przyspieszanych GPU, co znajduje odzwierciedlenie w strukturze przychodów segmentu generatywnej AI oraz zapowiedziach rozwoju infrastruktury przez głównych dostawców. Jednocześnie rosnące zużycie energii przez serwery akcelerowane będzie wymagało dalszych ulepszeń w zakresie efektywności energetycznej, zasilania i chłodzenia, ponieważ dynamika zapotrzebowania tych systemów przewyższa tempo wzrostu tradycyjnych wdrożeń.
W praktyce organizacje będą łączyć centra danych i przetwarzanie brzegowe, korzystać z wirtualizacji i konteneryzacji oraz zautomatyzowanego zarządzania, aby zapewnić skalowalność, bezpieczeństwo i wysoką dostępność z zachowaniem rozsądnych kosztów operacyjnych. W środowiskach krytycznych kluczowe pozostaną mechanizmy kopii zapasowych, replikacji oraz odtwarzania awaryjnego, które ograniczają skutki utraty danych.
Co jest najważniejsze, gdy wybierasz lub projektujesz serwery pod konkretne zastosowania serwerów?
Należy dopasować przeznaczenie i formę sprzętową do wymagań usługi, dobrać odpowiedni model udostępniania zasobów, oszacować charakter i zmienność obciążenia, określić miejsce działania w centrum danych lub na brzegu sieci, a także zaplanować bezpieczeństwo, monitoring i strategię skalowania. W zastosowaniach AI trzeba uwzględnić wymagania akceleratorów, przepustowości pamięci i sieci oraz wydajnego chłodzenia. W środowiskach o dużej skali znaczenie mają także koszty energii i parametry infrastruktury zasilająco–chłodzącej, ponieważ całe centra danych odpowiadają za zauważalny udział w globalnym zużyciu energii elektrycznej.
MaleWielkieDane.pl – portal o technologii bez marketingowego bełkotu. Piszemy o analizie danych, AI, cyberbezpieczeństwie i innowacjach dla ludzi, którzy potrzebują odpowiedzi, nie teorii.